AI 분석 도입 전, 데이터 권한 관리부터 확인해야 하는 이유
이미 BI를 운영하는 기업 가운데, 쌓아 둔 BI 데이터를 활용해 AI 분석을 해 보려는 곳이 늘고 있습니다. 새 데이터 파이프라인을 만들지 않고도, 잘 정리된 데이터셋을 그대로 AI에게 넘겨 질문할 수 있기 때문입니다.
이때 먼저 확인해야 할 것이 BI의 데이터 접근 제한, 특히 행 수준 보안(RLS)이 AI 분석에서도 지켜지는가입니다. 기업 데이터에는 매출, 인사, 고객 정보처럼 볼 수 있는 사람이 정해진 데이터가 섞여 있고, "누가 어떤 데이터를 볼 수 있는가"는 보안과 컴플라이언스의 출발점입니다. 그래서 AI 분석을 도입할 때는 BI에서 설정한 데이터 접근 권한이 AI 분석에서도 똑같이 지켜지는지 반드시 확인해야 합니다.
행 수준 보안(RLS)이란?
RLS(Row-Level Security, 행 수준 보안)는 같은 데이터셋이라도 사용자 역할에 따라 조회할 수 있는 행을 제한하는 데이터 접근 제어 방식입니다. 같은 건물에 출입하더라도 출입증에 따라 들어갈 수 있는 층이 다른 것과 비슷합니다. 영업팀장은 자기 팀 실적만, 지역 담당자는 담당 지역 데이터만 봅니다.
그런데 이 권한을 AI 분석까지 똑같이 적용하는 일은 생각보다 단순하지 않습니다. AI 분석 도구는 BI와 다른 시스템이라 BI의 권한 규칙을 알지 못합니다. 그렇다고 AI 쪽에 권한 체계를 따로 만들면 같은 정책을 두 곳에서 관리해야 하고, 두 정책이 조금만 어긋나도 볼 수 없어야 할 데이터가 보이게 됩니다.
AI 분석에도 BI의 권한을 똑같이 적용하는 방법
HEARTCOUNT는 BI와 AI Analytics를 함께 제공하는 플랫폼으로, BI 화면에서 버튼 하나로 데이터를 HEARTCOUNT AI Analytics로 넘겨 분석을 이어가는 연동 기능이 있습니다. HEARTCOUNT에서는 이 기능을 B-to-the-A라고 부릅니다. B-to-the-A 기능에서는, BI에서 AI로 분석을 확장하며 데이터를 넘길 때도 RLS가 동일하게 적용되도록 설계했습니다.
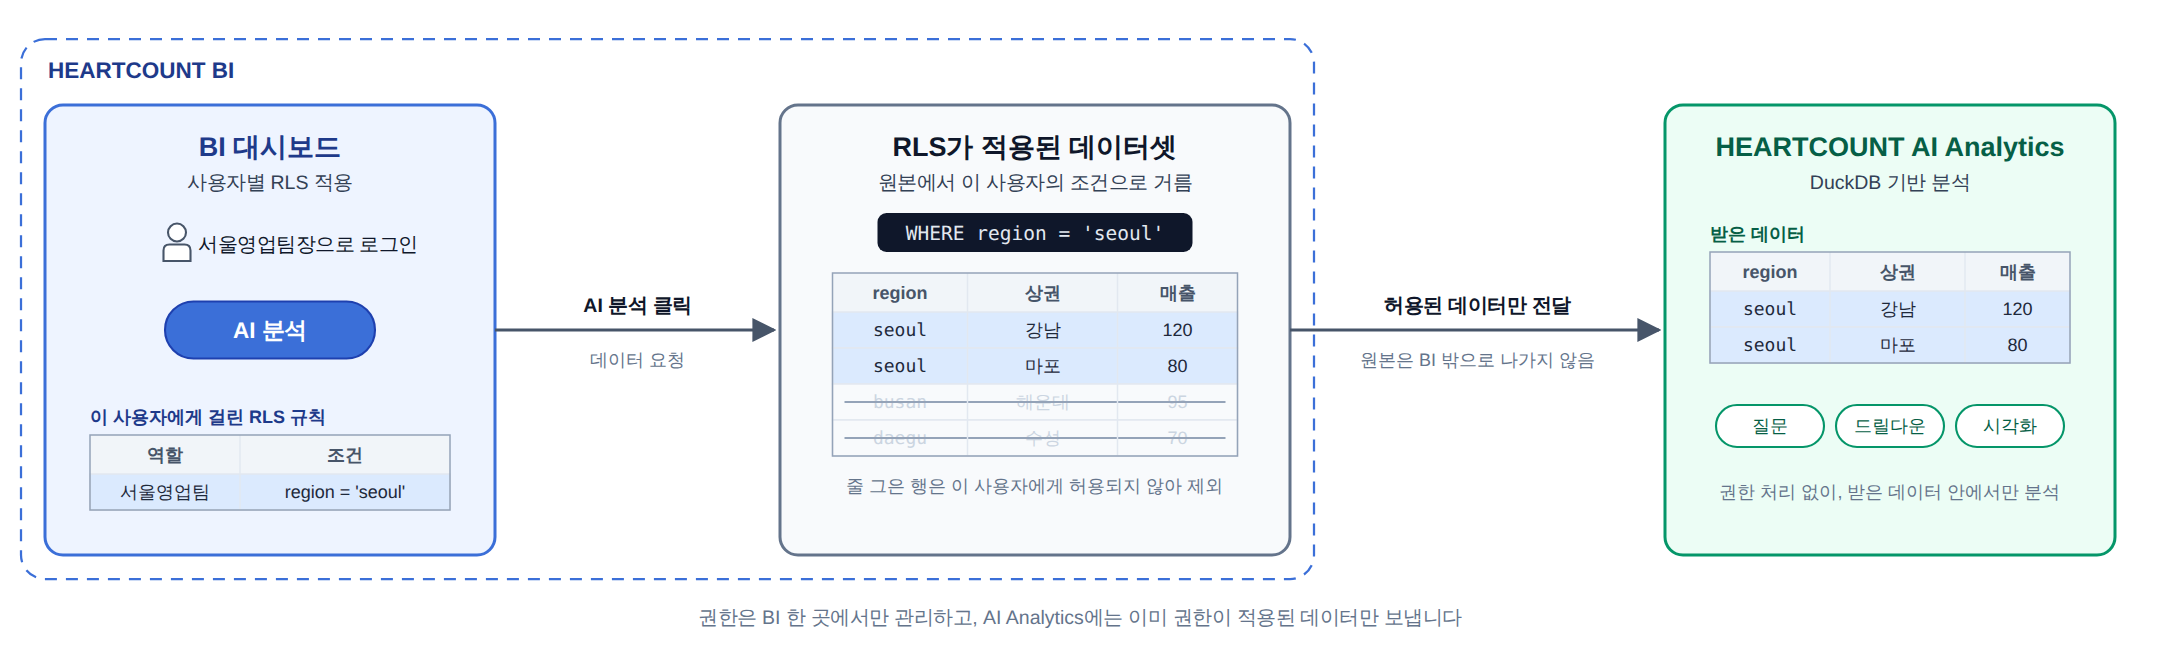
원칙은 하나입니다. 권한은 BI 한 곳에서만 관리하고, AI Analytics에는 이미 권한이 적용된 데이터만 보낸다. 보안 담당자부터 BI 관리자, 실무자까지 기존 환경에서 걱정 없이 AI 활용으로 업무를 확장할 수 있습니다.
- 보안 담당자: BI와 AI Analytics가 같은 데이터 접근 범위를 써 한번에 관리할 수 있습니다. BI에서 볼 수 없던 행은 AI Analytics에서도 볼 수 없고, 권한이 적용되지 않은 원본은 BI 밖으로 나가지 않습니다.
- BI 관리자: AI Analytics에 권한 정책을 따로 만들 필요가 없습니다. 권한은 지금처럼 BI에서만 관리하면 되고, AI 연동에서 지원하지 않는 조건은 저장하는 순간 이유와 함께 알려 줍니다.
- 현업 실무자: 따로 권한을 신청하거나 설정할 필요 없이, 대시보드에서 보던 데이터로 바로 AI 분석을 이어 갑니다.
BI의 RLS를 AI Analytics로 잇는 3단계
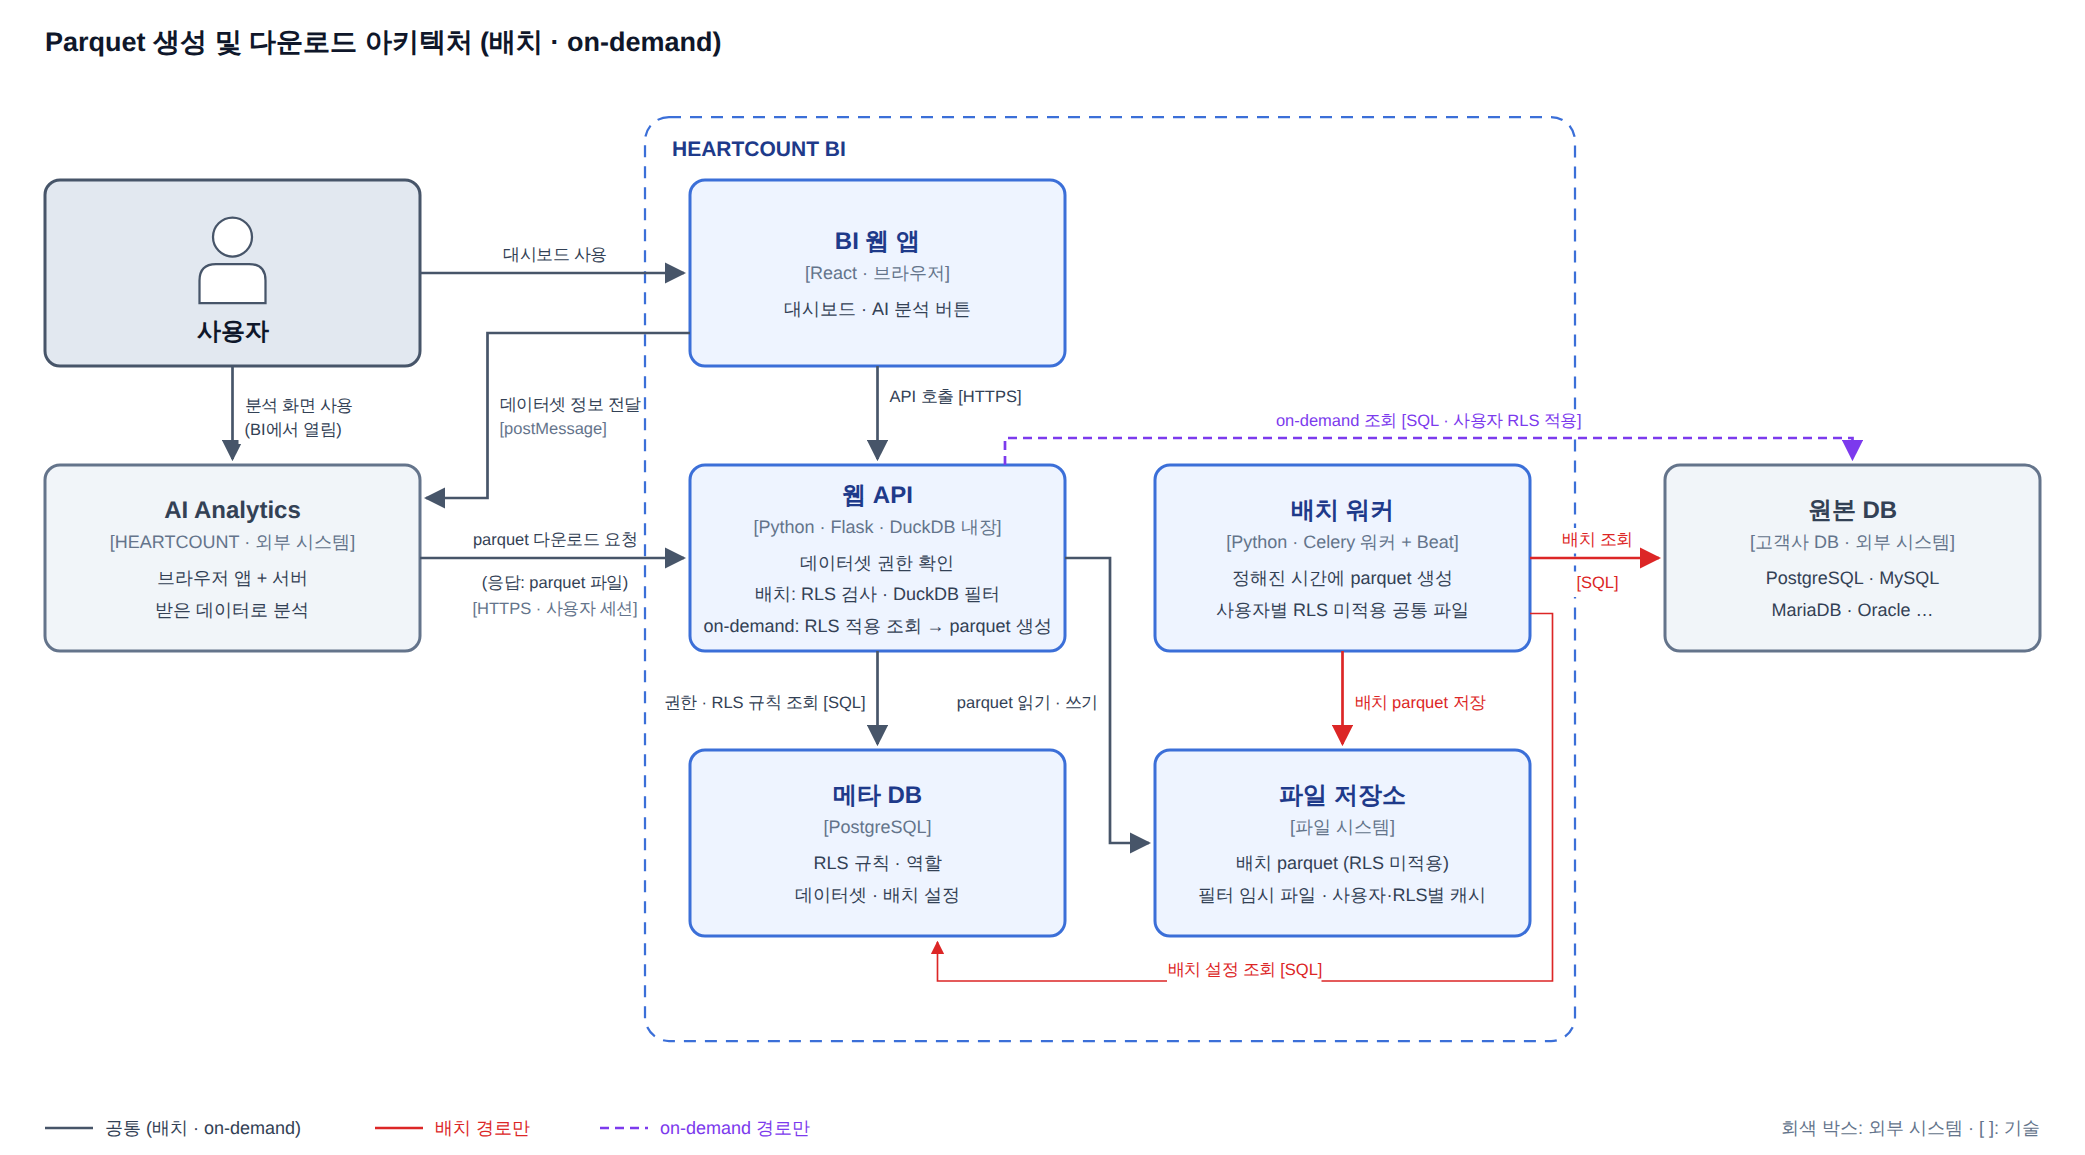
Step 1. BI에서 사용자별 RLS가 적용되는 방식
BI에서 RLS 규칙은 "어떤 데이터셋에, 어떤 역할에게, 어떤 조건을 붙일지"로 정의됩니다. 예를 들어 서울영업팀 역할에 region = 'seoul' 조건을 걸어 두면, 그 역할의 사용자가 차트를 열 때 BI가 쿼리에 조건을 자동으로 붙입니다.
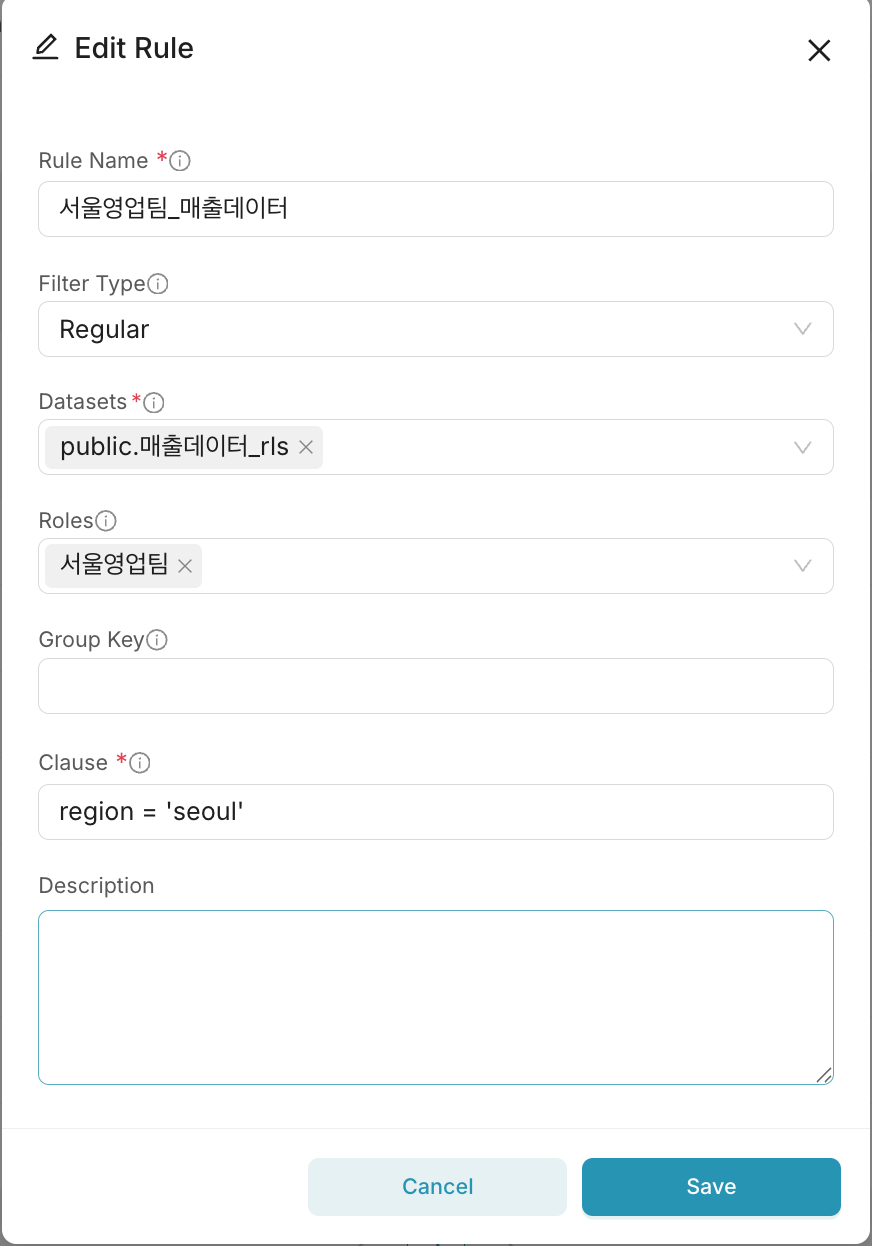
-- 차트가 만든 쿼리
SELECT region, SUM(amount) FROM sales GROUP BY region

-- 서울영업팀 사용자에게 실제로 실행되는 쿼리
SELECT region, SUM(amount) FROM sales WHERE (region = 'seoul') GROUP BY region
여러 역할에 속한 사용자는 역할별 조건이 함께 계산되고, owner = '{{ current_username() }}'처럼 로그인한 사용자 정보를 넣는 조건도 쓸 수 있습니다. 중요한 건 이 계산이 "지금 요청한 사용자"를 기준으로 이루어진다는 점입니다.
Step 2. 데이터셋에 RLS를 적용하는 시점
B-to-the-A가 AI Analytics로 데이터를 넘기는 방법은 두 가지입니다.
- 요청할 때 만들기: 버튼을 누르면 BI가 원본 DB를 조회해 파일을 만듭니다. 사용자의 요청 안에서 실행되므로 Step1에서 설정한 RLS가 그대로 붙습니다.
- 미리 만들어 두기(배치): 큰 데이터셋은 매번 조회하면 오래 걸리기 때문에, 관리자가 지정한 데이터셋은 정해진 시간에 parquet 파일로 미리 만들어 둡니다.
두 방법 중 무엇을 쓸지는 데이터셋에 따라 달라집니다. 배치 설정이 있는 데이터셋은 미리 만든 파일을, 없는 데이터셋은 AI 분석 요청이 들어오면 바로 파일을 만들어 넘깁니다. 요청 시 생성하는 파일에는 이미 사용자별 RLS가 적용되어 있으므로, 추가 필터링이 필요하지 않습니다.
배치 파일의 경우 사용자 요청 없이 미리 만들어지므로, 만드는 시점에는 누가 이 파일을 받을지 알 수 없습니다. 그래서 권한은 파일을 만들 때가 아니라 받는 시점에 적용하도록 설계했습니다. 설계 단계에서 비교한 두 방식은 이렇습니다.
| 방법 | 장점 | 단점 |
|---|---|---|
| 권한 조합마다 파일을 따로 만들기 | 원본 DB가 조건을 실행하므로 모든 조건 사용 가능 | 역할 조합 수만큼 파일과 생성 시간이 늘어남. 권한을 바꿔도 다음 생성 때까지 반영 안 됨 |
| 원본 하나만 만들고, 받을 때 거르기 | 파일 하나. 권한이 바뀌어도 파일을 다시 만들 필요 없음 | 받을 때마다 거르는 시간이 듦. 쓸 수 있는 조건에 제한이 생김 |
사용자 이름을 조건에 쓰는 규칙이 하나만 있어도 사용자 수만큼 파일이 필요해지기 때문에, 두 번째 방식을 택했습니다. 받는 순간 BI는 이렇게 처리합니다.
def prepare_download(batch_file, user_rls, settings):
    if not user_rls.clauses:                 # RLS가 없는 사용자는 원본 그대로
        return send_original(batch_file)

    where_parts = []
    columns = batch_file.columns
    for clause in user_rls.clauses:          # Step1과 같은 방식으로 계산한 이 사용자의 조건
        result = check_rls_clause(
            clause, engine=user_rls.engine, columns=columns
        )
        if not result.ok:                    # 검사를 통과하지 못하면
            return block(result.errors)      # 원본 대신 에러
        where_parts.append(f"({result.duckdb_sql})")

    filtered = run_duckdb_filter(
        batch_file, " AND ".join(where_parts), settings
    )
    return send_filtered(filtered)
배치 파일 다운로드 시 사용자별 RLS를 적용하는 예시 코드 (실제 코드를 단순화)
조건은 BI 본체가 대시보드에서 쓰는 계산을 그대로 가져오므로, 전달되는 데이터는 BI에서 해당 사용자에게 허용된 행의 범위를 넘지 않습니다. 거르는 작업은 DuckDB가 맡습니다. 다만 DuckDB가 권한을 판단하는 것은 아닙니다. 누가 무엇을 볼 수 있는지는 BI가 정하고, DuckDB는 BI가 넘긴 조건대로 거르기만 합니다.
Step 3. RLS가 적용된 데이터셋을 AI Analytics로 전달
- 사용자가 BI에서 AI 분석 버튼을 누르면 AI Analytics 창이 열리고, BI는 데이터셋의 다운로드 주소를 넘깁니다.
- AI Analytics 화면(브라우저)이 그 주소로 직접 데이터를 요청합니다. 그래서 이 요청에는 사용자의 BI 로그인 세션이 함께 실립니다.
- BI는 세션으로 요청한 사람이 누구인지 확인하고, 그 사람의 데이터셋 접근 권한을 먼저 검사합니다. 권한이 없으면 데이터셋이 있다는 사실조차 알려 주지 않습니다. 권한이 있으면 그 사람의 RLS로 거른 파일을 내려 줍니다.
AI Analytics는 받은 데이터를 분석에 쓰면 됩니다. 권한은 이미 적용되어 있기 때문입니다.
AI Analytics로 전달할 때 권한을 지키는 4가지 원칙
원본을 하나 만들고 받을 때 권한에 따라 데이터를 거르는 배치 방식에서는, 원래 원본 DB에서 실행하던 RLS 조건을 DuckDB에서 실행합니다. 두 엔진이 같은 조건을 다르게 해석하거나 조건이 의도와 다르게 실행될 여지가 없도록, 네 가지 원칙을 두었습니다.
① 조건을 그대로 실행하지 않는다
RLS 조건을 문자열이 아니라 구문 트리로 분석하고, 모든 부분이 허용 목록에 있는지 확인합니다.
def predicate(self, node, negated=False):
    if isinstance(node, (exp.And, exp.Or)):
        self.predicate(node.left, negated)
        self.predicate(node.right, negated)
    elif isinstance(node, exp.Not):
        self.predicate(node.this, not negated)    # NOT이 몇 번 걸렸는지 추적
    elif isinstance(node, (exp.EQ, exp.NEQ, exp.GT, exp.GTE, exp.LT, exp.LTE)):
        self.comparison(node, negated)
    elif isinstance(node, exp.In):
        self.in_(node, negated)
    # ... LIKE, BETWEEN, IS NULL 등
    else:
        self.not_allowed(node)                    # 목록에 없으면 전부 차단
금지어 목록이 아니라 허용 목록이라, 지원 여부를 판단할 수 없는 문법은 허용하지 않고 막습니다. 검사를 통과하면 원래 문자열은 버리고 검사한 트리에서 DuckDB용 SQL을 새로 만들어 실행합니다.
② DB마다 비교 기준이 달라 권한 밖의 데이터가 나갈 수 있는 조건은 막는다
같은 조건이라도 DB마다 문자열을 비교하는 기준이 다릅니다. 지원하는 DB별로 실제 결과를 대조해 차이가 나는 경우를 정리했고, 대표적인 예가 MySQL 계열입니다.
| 조건 | MariaDB | DuckDB |
|---|---|---|
region = 'seoul' |
'seoul', 'Seoul', 'seoul ' |
'seoul'만 → 원본보다 적음 |
region <> 'seoul' |
나머지 | 'Seoul', 'seoul '까지 → 원본보다 많음 |
MySQL 계열은 대소문자와 끝 공백을 무시하는 collation(MariaDB 기본값 등)을 쓰면 'Seoul', 'seoul '도 'seoul'과 같다고 보지만, DuckDB는 정확히 비교합니다. 그래서 긍정 조건에서는 허용된 행 일부가 빠질 수 있고, 부정 조건에서는 권한 밖의 행이 포함될 수 있습니다. 그래서 MySQL 계열에서는 부정 위치의 문자열 비교를 허용하지 않습니다. 위 코드에서 negated를 따라다니게 한 이유입니다.
③ DuckDB가 접근할 수 있는 범위를 제한한다
검사를 통과한 조건만 실행하더라도, 한 겹 더 막아 둡니다. DuckDB의 파일·네트워크 접근 범위를 제한해서, 서버의 다른 파일을 읽을 수 없게 합니다.
con.execute("SET memory_limit = '1GB'")
con.execute("SET allowed_directories = ['/path/to/batch/', '/path/to/rls_work/']")
con.execute("SET enable_external_access = false")   # 그 밖의 파일·네트워크 접근 차단
con.execute("SET lock_configuration = true")         # 이후 설정 변경 금지
배치 경로에서 사용자별로 걸러 만든 임시 파일은 전송과 동시에 서버에서 지워지고, 브라우저 캐시에도 남지 않게 응답합니다.
④ 확실하지 않으면 보내지 않는다
서브쿼리, DB마다 동작이 다른 함수처럼 권한 범위를 넘지 않는다고 확인할 수 없는 조건은 관리자가 RLS를 저장할 때 미리 막고, 받을 때 한 번 더 검사합니다. 조건 검사에 실패해도, 동시 요청이 몰려도, 필터링 중 오류가 나도 권한이 적용되지 않은 원본을 대신 보내지 않습니다.
BI에서 AI 분석까지, 사용자 경험은 어떻게 달라질까요?
지역별 매출 대시보드를 보던 서울영업팀장이 특정 상권의 실적 하락을 발견했다고 가정해봅시다.
- BI에서 매출 현황 확인: 대시보드에는 서울 지역 데이터만 보입니다. RLS가 적용된 화면입니다.
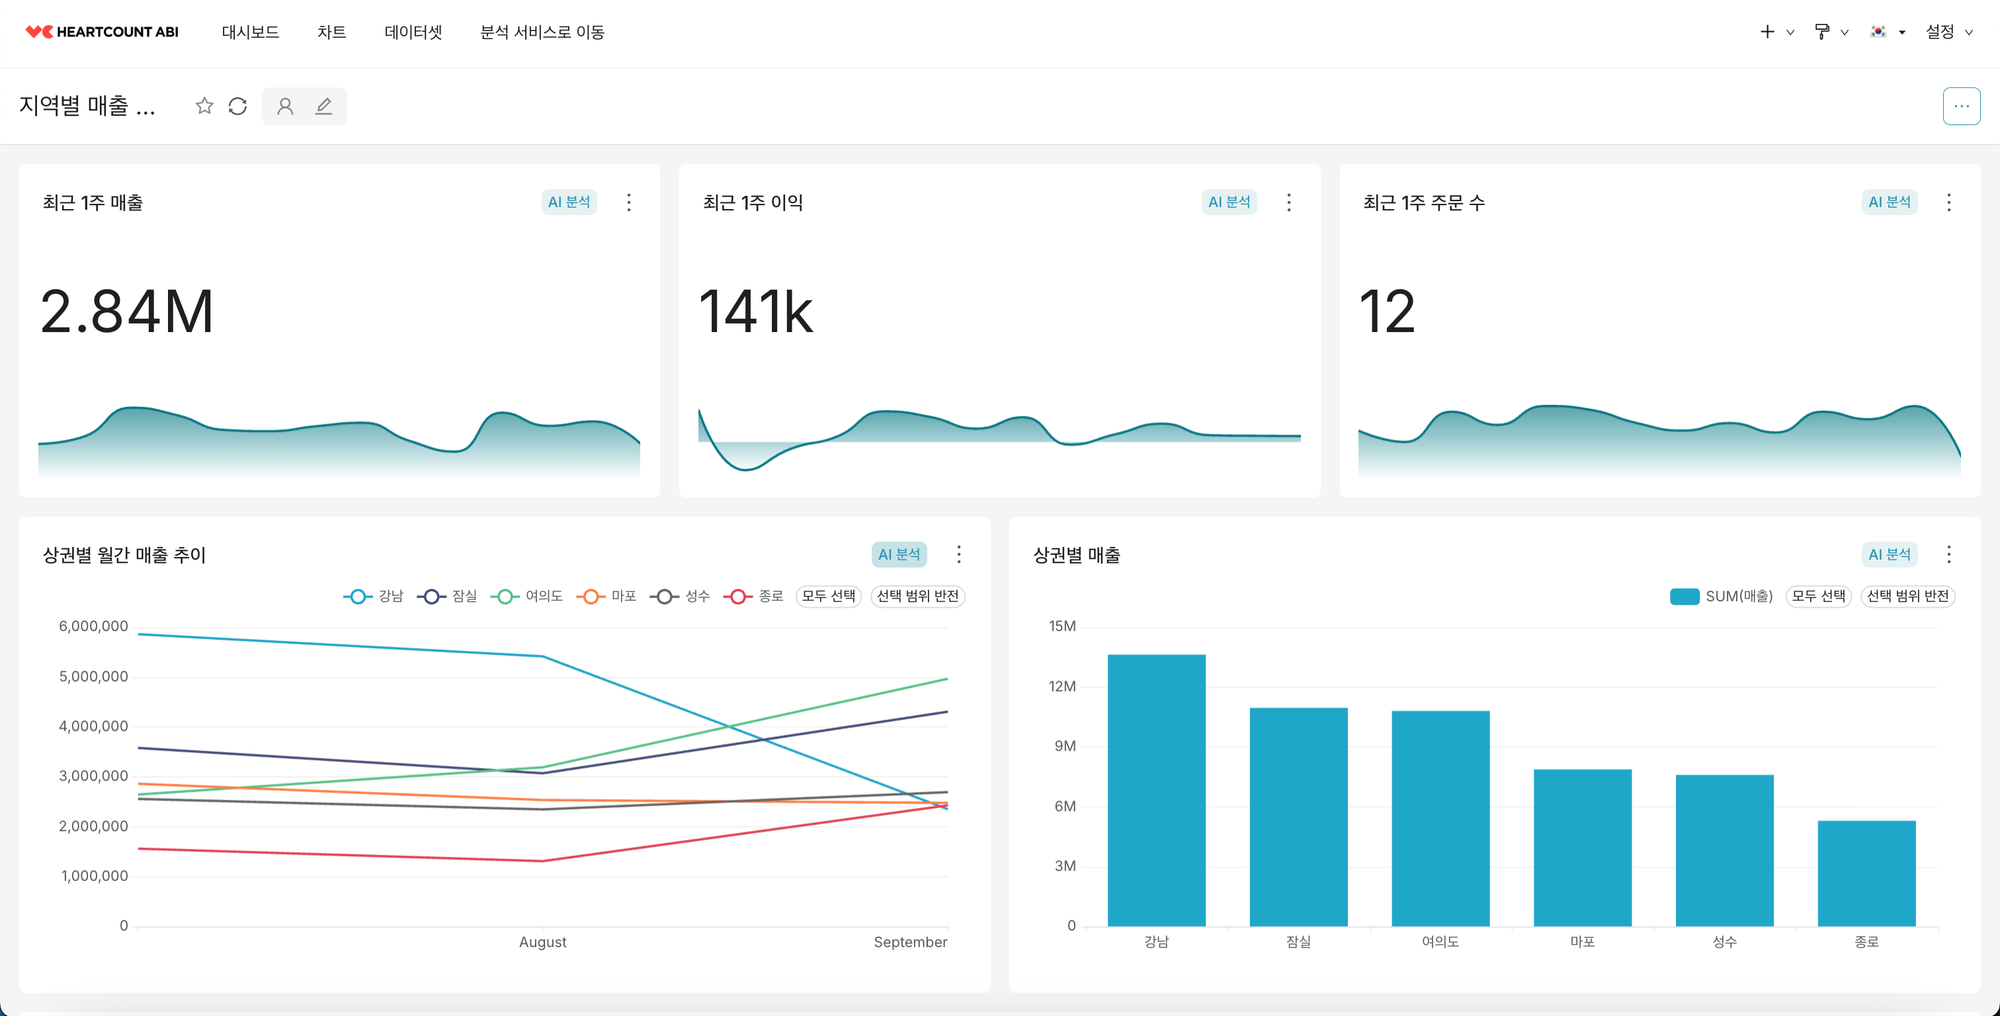
AI 분석버튼 클릭: 따로 권한을 설정할 필요 없이 AI 분석 화면이 열리고, BI에서 보고 있던 서울 지역 데이터가 넘어갑니다.- 같은 권한 안에서 원인 탐색: "이 상권의 매출이 왜 떨어졌는가"를 묻고, 상품군과 기간별로 하락 요인을 찾아갑니다. 다른 지역 데이터는 처음부터 넘어오지 않았으니 분석 결과에도 섞이지 않습니다.
- 드릴다운과 시각화: 원인으로 보이는 항목을 더 쪼개 보고, 필요한 차트를 만들어 공유합니다.
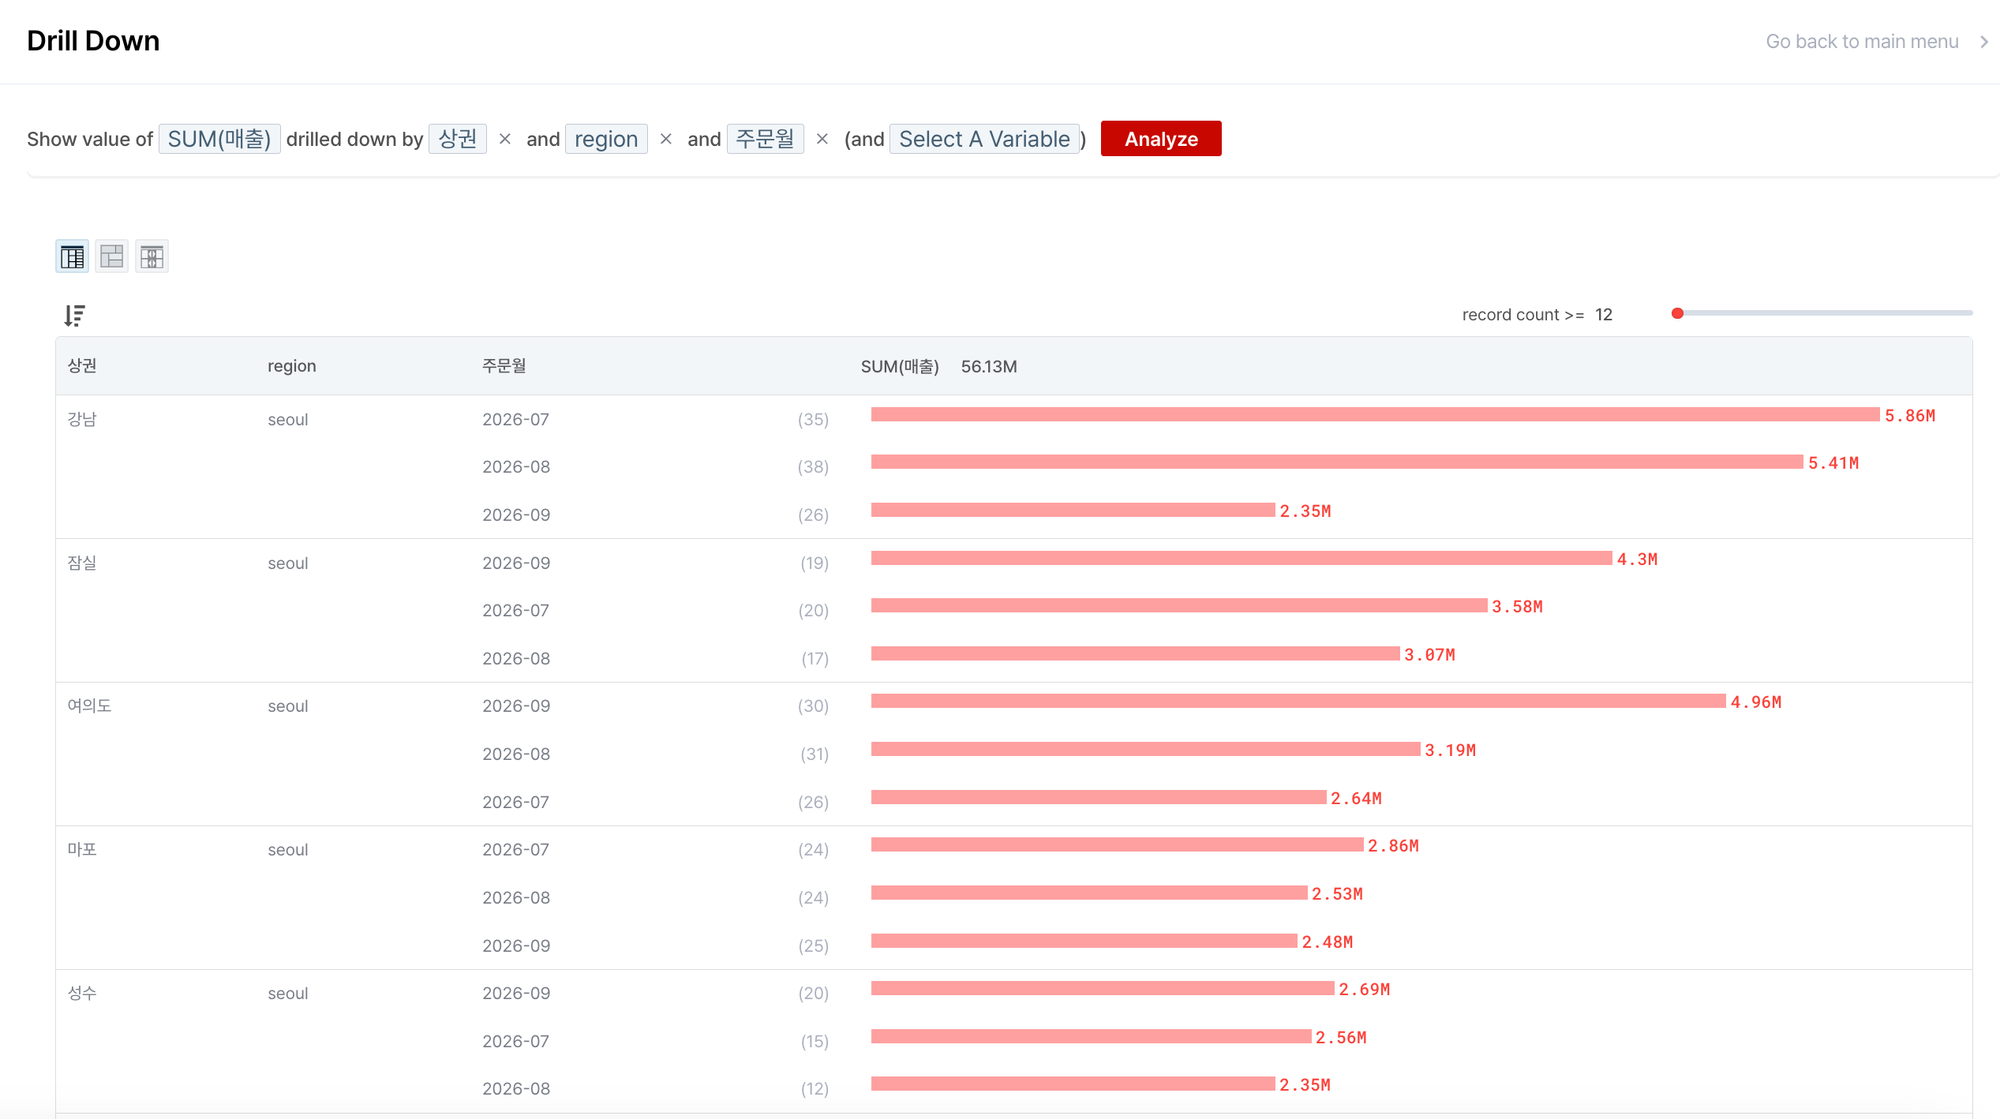
사용하는 서비스가 BI에서 AI로 확장됐지만, 권한 정책을 관리할 곳은 늘어나지 않습니다. 권한은 지금처럼 BI에서만 관리하면 됩니다. AI 연동에서 지원하지 않는 형태의 조건을 저장하려고 하면 저장 단계에서 바로 이유를 알려 주기 때문에, 운영 중에 문제가 드러나기 전에 고칠 수 있습니다.
AI 분석 도입, 권한 관리가 먼저입니다
어떤 AI 분석 도구를 쓰든, BI 데이터를 AI로 넘기는 순간 권한 문제도 함께 넘어갑니다. BI에서 볼 수 없던 데이터가 AI 쪽에서 보인다면 그동안 설정한 접근 통제는 의미를 잃습니다.
HEARTCOUNT는 BI에서 설정한 행 수준 보안(RLS)이 AI 분석에도 똑같이 적용되도록 설계했습니다. 권한은 지금처럼 BI 한 곳에서만 관리하면 되고, AI를 붙였다고 관리할 곳이 늘어나지 않습니다. DB손해보험 등 권한 요건이 까다로운 금융권에서도 HEARTCOUNT로 권한 체계를 운영하고 있습니다.
AI 분석 도구를 검토하고 있다면, 기능 비교에 앞서 아래 세 가지를 먼저 확인해보세요.
- 기존 데이터 접근 권한이 AI 분석에도 똑같이 적용되는가?
- 권한 정책을 BI와 AI 도구, 두 곳에서 따로 관리해야 하는가?
- 권한 검사에 실패하거나 오류가 나면, 권한이 적용되지 않은 원본 데이터가 전달될 가능성은 없는가?
권한 관리가 확실해야 AI 분석을 조직 전체로 넓힐 수 있습니다.
HEARTCOUNT에서는 BI와 AI 분석을 한 플랫폼에서 쓰기 때문에, BI에서 설정한 권한 하나로 AI 분석까지 안심하고 운영할 수 있습니다. 권한 관리 부담 없이 BI와 AI 분석을 함께 도입하고 싶다면 지금 도입 상담을 시작해보세요.
다양한 도메인의 HEARTCOUNT 도입 사례가 궁금하다면 고객 사례집을 신청해보세요. 신청 즉시 이메일로 전송됩니다.
함께 읽어보세요
 Sun Jung
 Joe